
我為你歸納了關於歸納的知識(歸納邏輯)
歡迎回來,我們繼續聊邏輯。
上期說,我們要在邏輯知識和邏輯能力之間搭一座橋,橋上有三把利劍、三枚盾牌和一面鏡子,藉助它們,我們將認識「三種推理」和「三類謬誤」,澄清「邏輯與口語表達」之間的關係。
上期,我們拔起了演繹之劍。從AEIO到Alpha Go,不愧是最鋒利的邏輯之劍,但我們卻說它是最難用的劍,人類只能以外掛的形式來使用它的力量,為什麼要這麼埋汰人類呢?
有限理性
請聽題:
湯質盯著張三,張三盯著韓梅梅,湯質已婚,韓梅梅未婚,問,是否有一個已婚人士盯著一個未婚人士?
- 是
- 不是
- 不確定
很多人會選C,因為題目中沒有給出確定的信息,我們不知道張三婚否。
問題選自心理學家斯坦諾維奇的著作《超越智商》,據說無論智商高低,80%的人都會做錯。
正確答案只能是A。
在一個邏輯系統中,張三「婚否」是不重要的,他要麼已婚,要麼未婚。無論已婚未婚,所以給定的前提下,一個已婚人士看著一個未婚人士是必然成立的。
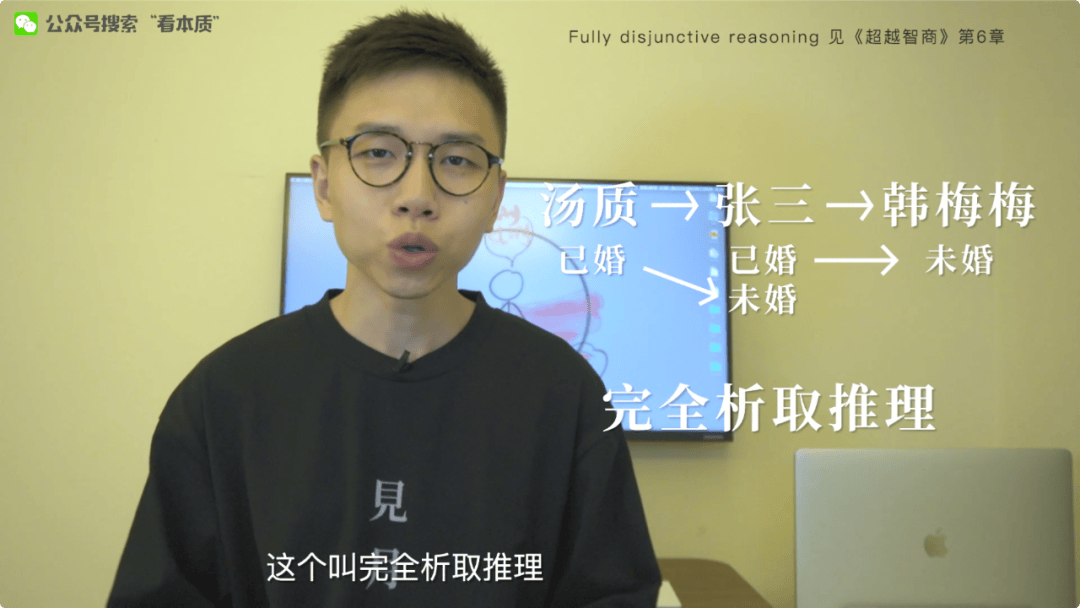
上面這種推理叫「完全析取推理」(fully disjunctive reasoning),它要求你對**「所有邏輯可能性」**進行分析,演繹出一個必然包含在前提中的結論。
計算機就是這麼“自然而然地”思考的,對人來說卻極不自然。用斯坦諾維奇的話說,我們都是**「認知吝嗇鬼」**——選項C與直覺最相符,在過往經驗中,類似的狀況都應該選C,於是大腦完成了一個隱秘的而高效的歸納,跳過了細緻的思考。
我們是名副其實的演繹殘廢。
雖然這種吝嗇和殘廢常常給我們使絆子,但我們也得承認,它是人類高效思考的前提。
道理很簡單,「是不是有個已婚人士看著未婚人士」這種奇怪的問題只會在心理學測驗中出現,真實世界中的問題是複雜且模糊的。比如我該從事什麼職業,我該留在大城市還是回老家發展,一隻股票該買入還是賣出等等。如果人在做每一項決策時,都要考慮**「所有變量」的「所有邏輯可能性」**,那麼任何一個簡單的判斷,都會變得極其複雜,以至於無法判斷。
所以,我們的大腦無法處理,也無需處理所有邏輯可能性,絕大多數情況下,我們只需要處理「有限的經驗可能性」就足夠了。
人類的知識就是這樣運行的。
對此,認知科學界公認的大神,在本節目出鏡率很高的赫伯特·西蒙做過一個非常精彩的概括:
知識的使命,就是從所有的邏輯可能性總類中選出一個其經驗可能性較為有限的子類,從而在描述可能性的各變量之間建立一定的功能聯繫。
知識的最終目的是確定過去和現在已知事實與將來的事實之間的關係,從而由當前狀況產生唯一一種可能性。我想像不出比這一表達更徹底的關於知識用途的工具觀了。
《司馬賀傳:穿越歧路花園》
拿掉定語,其主旨是:
知識的使命,是從總類中選出子類,從而在各變量之間建立聯繫。知識的最終目的是,確定事實與事實之間的關係,從而由狀況產生可能性。
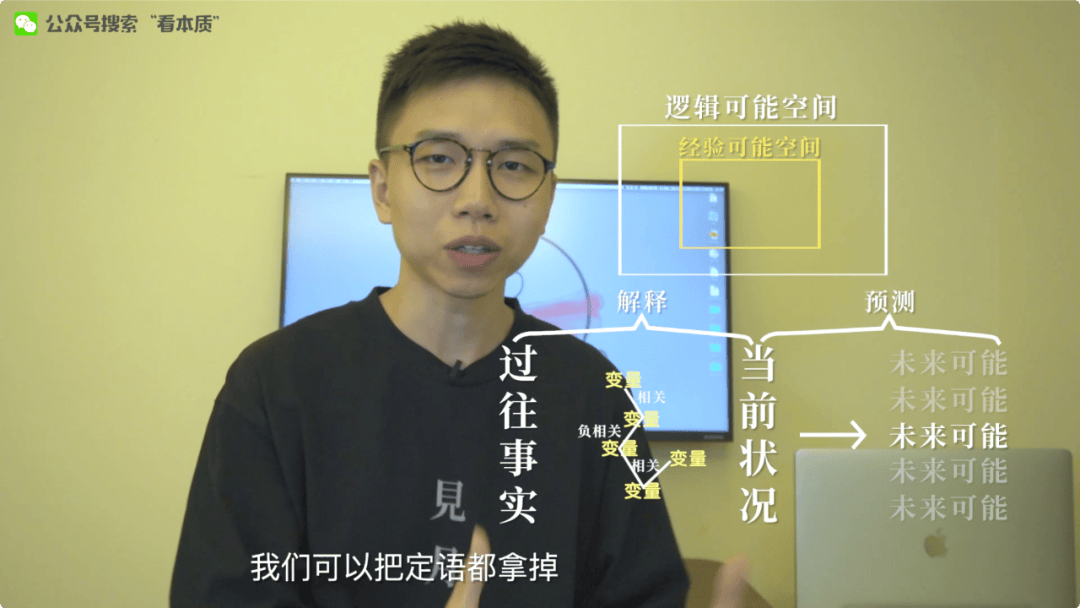
「有限理性」(bounded rationality)是西蒙最著名的理論,是認知科學、行為經濟學中最重要的理論假設之一。他認為,人只能在一個封閉的變量系統中才能做出有效決策。
任何一個對象都有無限細節,一滴水、一個人、一個社會,我們只能在無限細節中的框定出有限的變量,才有可能尋出其中規律。
比如我們可以找出與「職業選擇」有關的重要變量來制定決策,也試圖通過某些關鍵變量來預測一個股票的長期價格走勢,變量選得好,能保證我們在大部分狀況下做出相對符合趨勢的決策。
重點來了,我們必須通過「有效的歸納」才能做到這一點。
將性質歸結為類型
上期說過,歸納是從小范疇中發現大範疇、從個別(特稱命題)發現一般(全稱命題)的推理,與演繹推理的“路徑”正好相反。
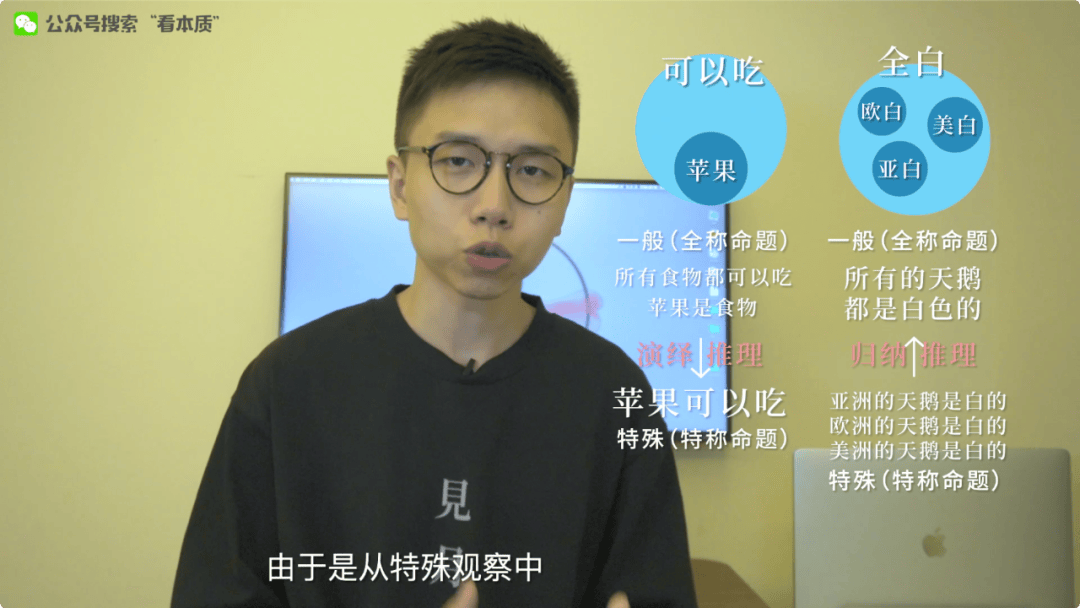
在邏輯學中,歸納推理的基本形式是:
- 觀察到a、b、c都屬於S且是P(a,b,c都屬於天鵝,且是白色的)
- 沒有東西被觀察到屬於S且不是P(沒有觀察到天鵝的不是白色的)
- 所有S都是P(所有天鵝都是白色的)
(注:S指主項Subject,P指謂項Predicate)
由於是從特殊觀察中推出一般結論,所有它不是必然有效的,屬於或然性推理。所以前面「有效的歸納」的說法是錯的,更準確的說法是高強度的歸納。
有關歸納推理的本質特徵,維基詞條一語道破天機:
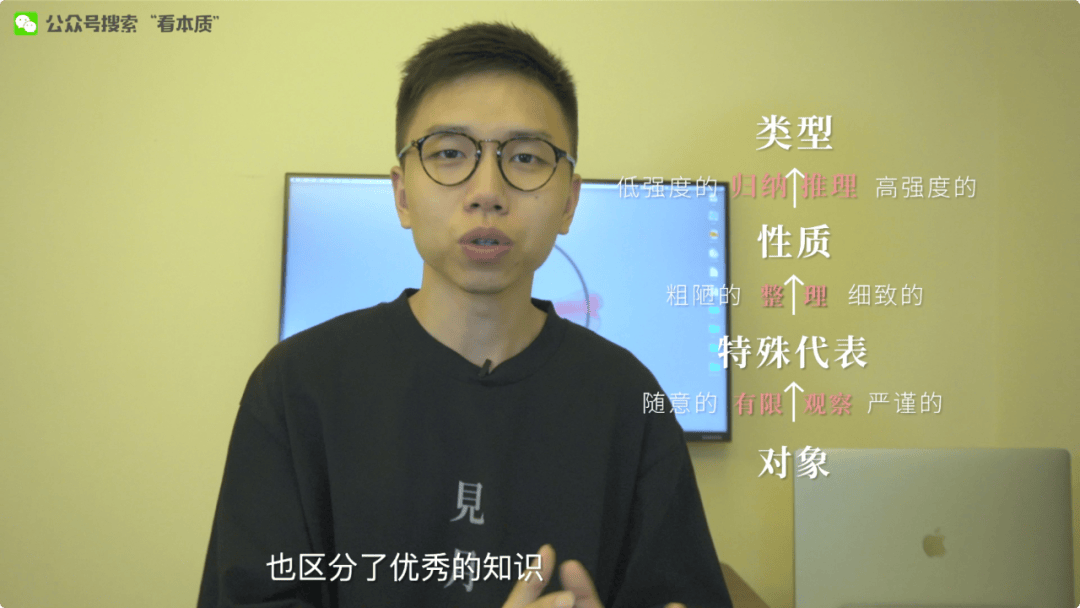
(歸納推理)基於對特殊的代表的有限觀察,把性質(或關係)歸結為類型。
注意這裡的表述:特殊代表的有限觀察,性質歸結為類型。
我們離不開歸納,是因為我們的經驗永遠來自有限觀察,對事物的理解又總是類型化的。
於是,如何觀察特殊代表,把哪些性質歸結為何種類型,就拉開了人與人思考質量的差距,區分了好知識和壞知識。
前面講「職業選擇」時一晃而過的圖示,其實是人力資源界鼎鼎大名的霍蘭德職業模型,一個久經考驗的經驗模型。
它在影響職業選擇的個人特性中找出了兩個關鍵性質(關鍵變量)。
- 第一個特性是人的行動偏好,有人喜歡想,有人喜歡幹。
- 另一個特性是人的對象選擇偏好,有人喜歡面對“人”,有人喜歡面對“事”。這兩個特性,就是兩個關鍵變量。
然後把人劃分成了六種類型。
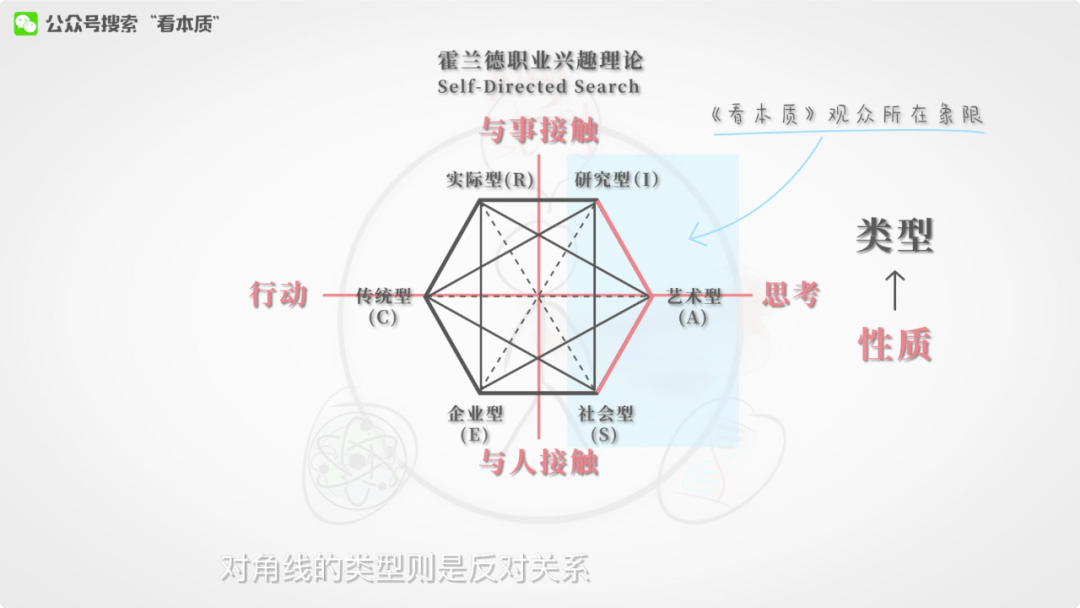
比如行動力強且喜歡與人打交道的人,是企業型,適合帶團隊、當領導。
喜歡思考且喜歡琢磨事物的人,是學者型,適合搞研究、當學者。
臨近的類型往往有高度關聯性,對角線的類型則是反對關係。
這樣,每個人都會有自己的霍蘭德代碼,對應特定的職業類型。
基於類似的思路,還可以把人分成了五種、九種、十二種、甚至十六種……但無論多少種,它們都是幫我在邏輯可能性的總類(人性的所有可能)中找出經驗可能性有限的子類(人格類型-職業類型),並描述變量間功能性聯繫的「知識」,基於歸納的知識。
從二元到多元
和你們一樣,我特別喜歡這類知識,它能讓你在付出極低認知成本的情況下,為複雜對象建立起一個簡化理解的框架,這種相對高級的歸納,能幫助我們超越“原始人歸納法”的侷限性。
原始人歸納法當然是我杜撰的詞,其實就是二分法,好人/壞人,危險的事/安全的事,喜歡的工作/不喜歡的工作,重要的事/不重要的事。二分法是基於單個性質(變量)的粗暴分類,我們還說不清這個性質(變量)是啥,什麼是好,什麼是安全,什麼是重要?所有的判斷都來自於生存本能。
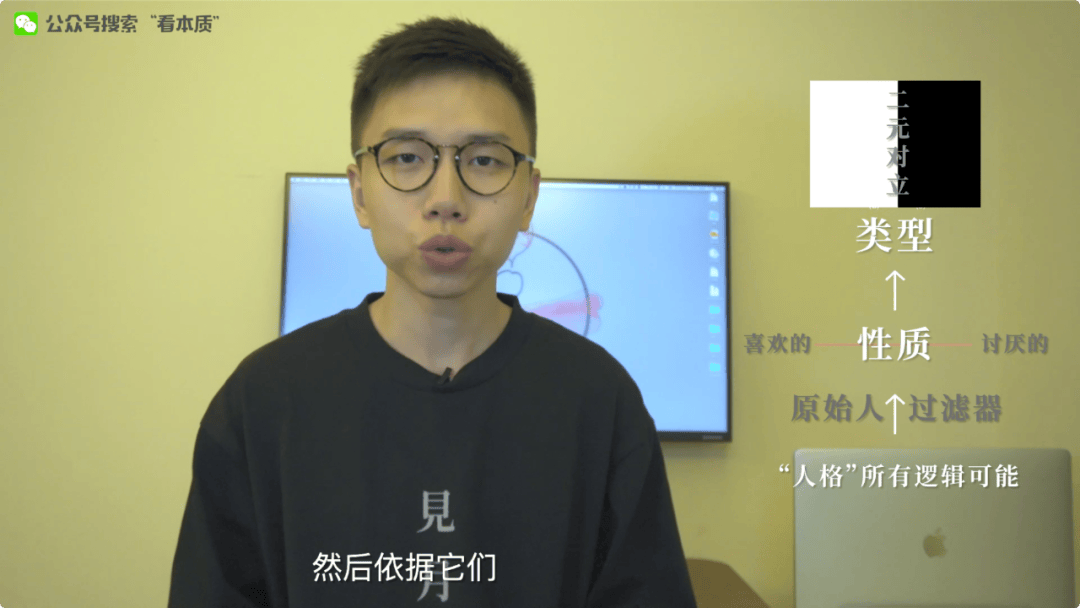
前面講的這類知識,之所以相對高級,就在於它們找出了更多變量,劃分出了更多類型,讓我們對事物有了多元的認知。
但我總是強調它們「相對」高級,因為這類知識有一個明顯的弊端,就是它們顯得不“科學”。
十二生肖和六十四卦也為我們提供了簡化框架,它和六型人格、九型人格,十六型人格有什麼本質區別嗎?
要回答這個問題,我們必須深刻地理解「歸納推理」的本質。當我們談論科學性時,我們是在談論客觀性和嚴謹性,當我們談論客觀性和嚴謹性時,我們其實在討論「歸納強度」。
有些嚴肅的科學知識看起來格外牛逼,有數學化的表達形式,有精確的預測能力,雖然看起來和前面這些簡單歸納出來的傢伙完全不是一路貨色,但它們本質上都是經驗模型,關鍵差別在於,它們對原始經驗材料歸納強度完全不同。
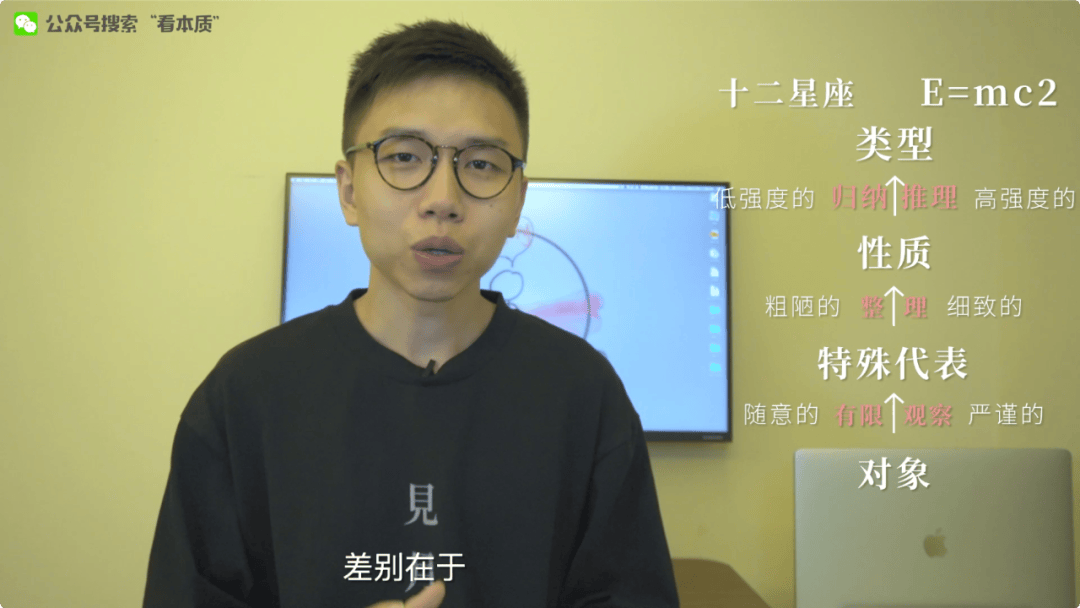
科學發展史,某種程度上就是一部曲折的歸納技能強化史,下面我們來仔細談談。
從直觀到實證
今天的知識之更所以精確,首先是歸納方法進步了。
密爾在《邏輯學體系》為歸納梳理出了五種方法,簡稱密爾五法,將歸納從一種不自覺的認知方式提煉成了研究因果的方法,為實證科學奠定了基礎。
密爾五法的第一個方法求同法就是最經典的歸納法,科學家在情境1中觀察到事件ABCD和現象wxyz一起發生;在情境2中觀察到事件AEFG和現象wtuv一起發生;因此推斷A可能是w的原因或結果。
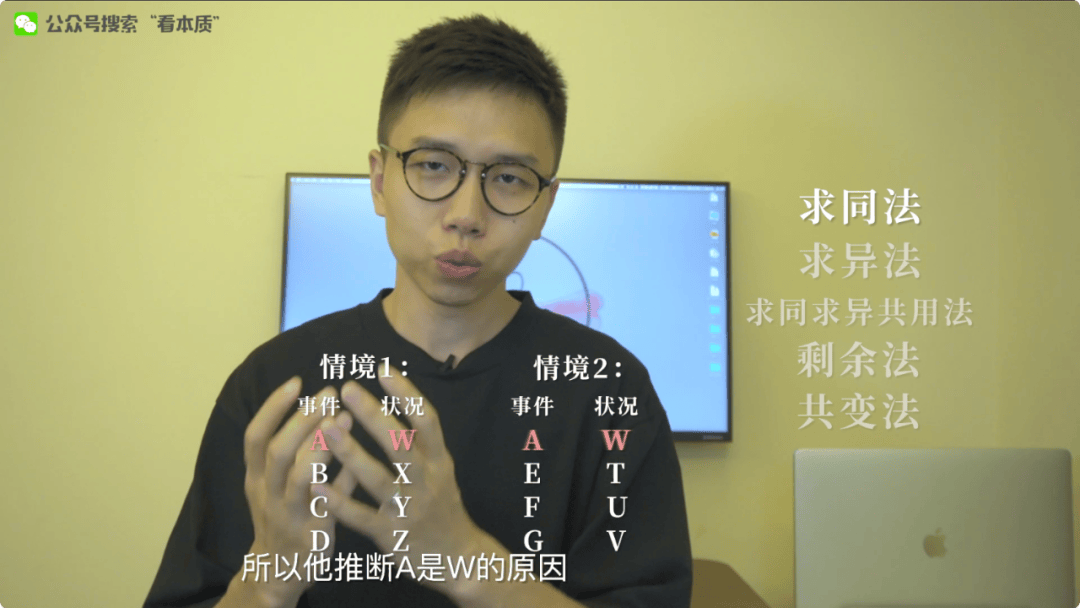
比如在過去十天裡,我有三天狀態特別好,思路特別清楚,正好我這三天的早上都去跑步了,由此我得出一個結論,跑步會導致狀態變好。
求同法是最自然而然的歸納方式,它的侷限性很明顯。
首先是無法區分原因和結果,不知道是因為狀態好才去跑步,還是因為跑步了狀態才好;其次是我們觀察到所有影響因素,也許那三天還有別的事情同時發生,比如睡得早,吃得好了,稿子寫到了容易的部分了,天不下雨了,它們都會同時影響到我跑步的意願和思維的狀態,這裡面的因果關係是糾纏不清的。
你觀察到的是ABCD和現象wxyz一起發生,事實上發生的事情一個字母表都數不過來。
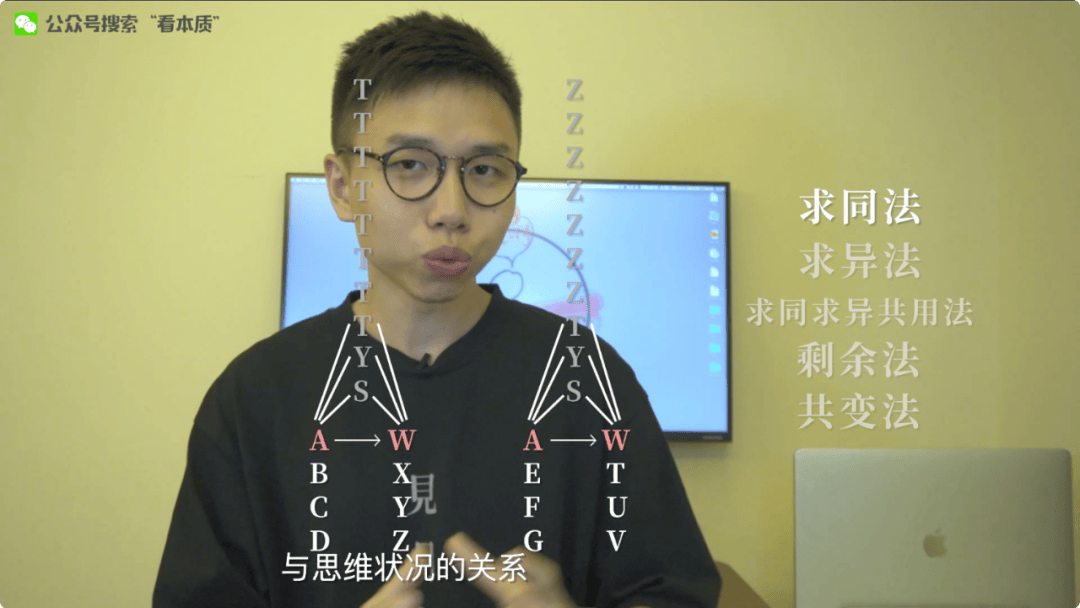
無論我們要探究跑步與狀態的關係,還是發現某種習慣與疾病的關係,乃至搞清楚某種行為偏好與社會成就的關係,就都會遇到類似的障礙。
除非,有一個平行宇宙,平行宇宙的你除了不愛跑步,其他一切都不變,你才能確切地指出它們之間存在某種因果關係。
這就是求異法的思路。
- 你在情境1中觀察到事件ABCD和現象wxyz一起發生。
- 接著在情境2中觀察到BCD和xyz一起發生。
於是推測A是w的原因或結果,或是重要的相關因素。
求同法從共有事件中尋因果關係,求異法從差異事件中尋找因果關係。差異性比共性更容易察覺,而且我們可以通過人為干預來製造差異,所有求異法比求同法更具普適性。
“求異”也科學發現的普遍思路,通過建立對照組,科學家能非常方便地使用求異法來發現因果。
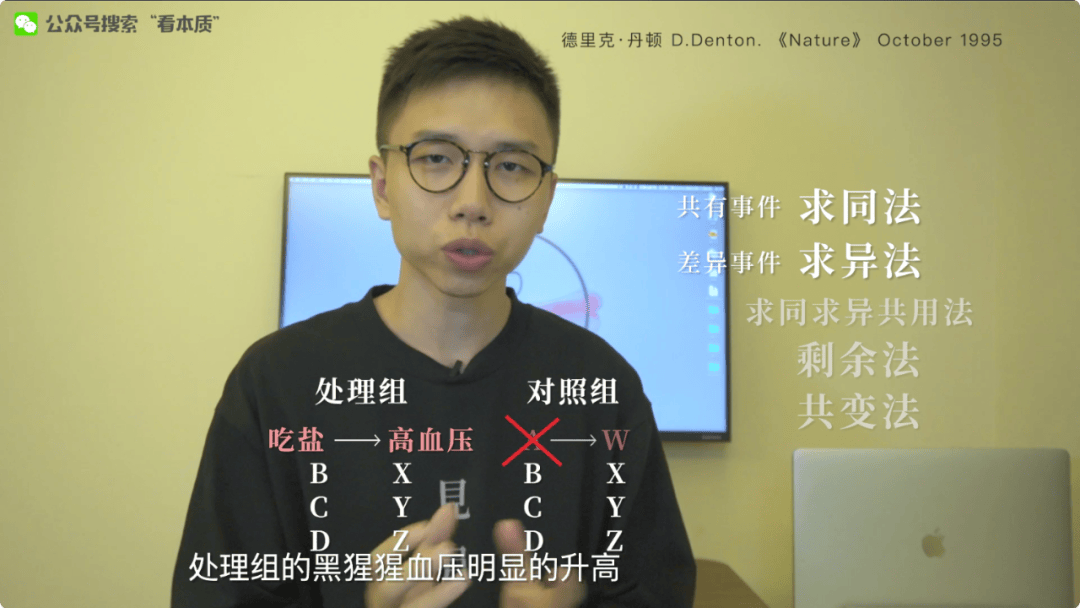
90年代,科學家懷疑吃過量的鹽會導致高血壓和心臟病,於是拿黑猩猩做實驗,處理組吃含鹽量高的食物,對照組吃正常的食物,持續20個月,結果處理組的血壓明顯高於對照組。之後實驗人員降低了處理組食物中的含鹽量,血壓隨之降低。於是研究人員得出了吃鹽會導致血壓升高的結論,更準確的說法是,得出了「吃鹽會導致黑猩猩血壓升高」的結論。
但過量吃鹽是否會導致人的血壓升高呢?我們並不能肯定,人的生活都環境也比猩猩複雜很多,過去的生活作息、飲食習慣很難被準確收集,更何況,給一群無辜的人吃有潛在健康風險的高鹽飲食在倫理上是不被允許的。
在這種情況下,嚴格意義上的求同和求異都無法使用,只能使用共變法。
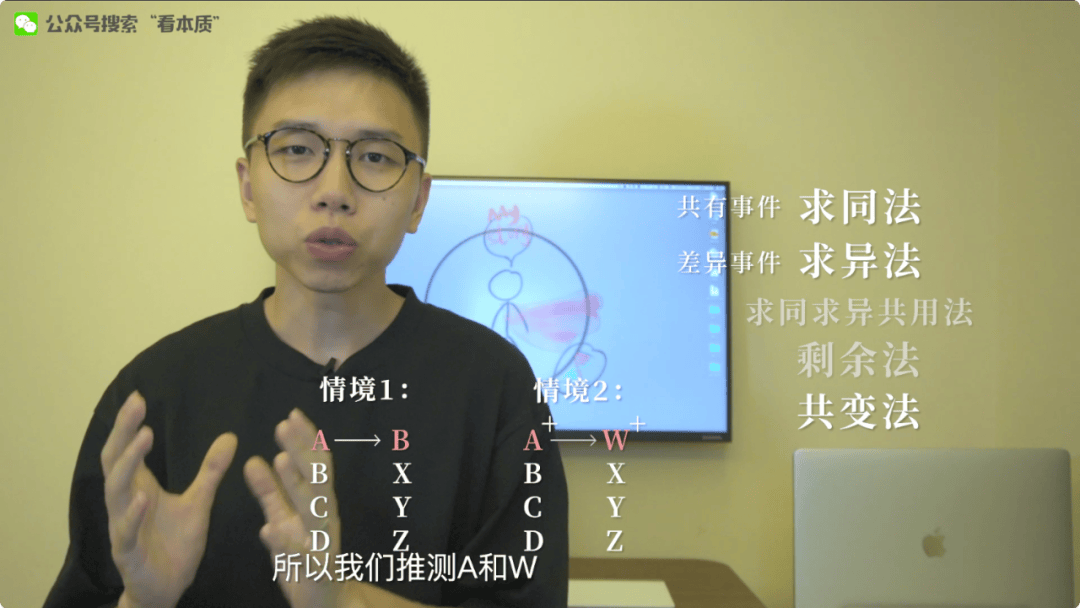
- 在情境1中,ABCD與wxyz同時發生;
- 情境2中,A發生了某種變化,w也發生了某種變化,我們推測A和w有某種程度上的關聯。
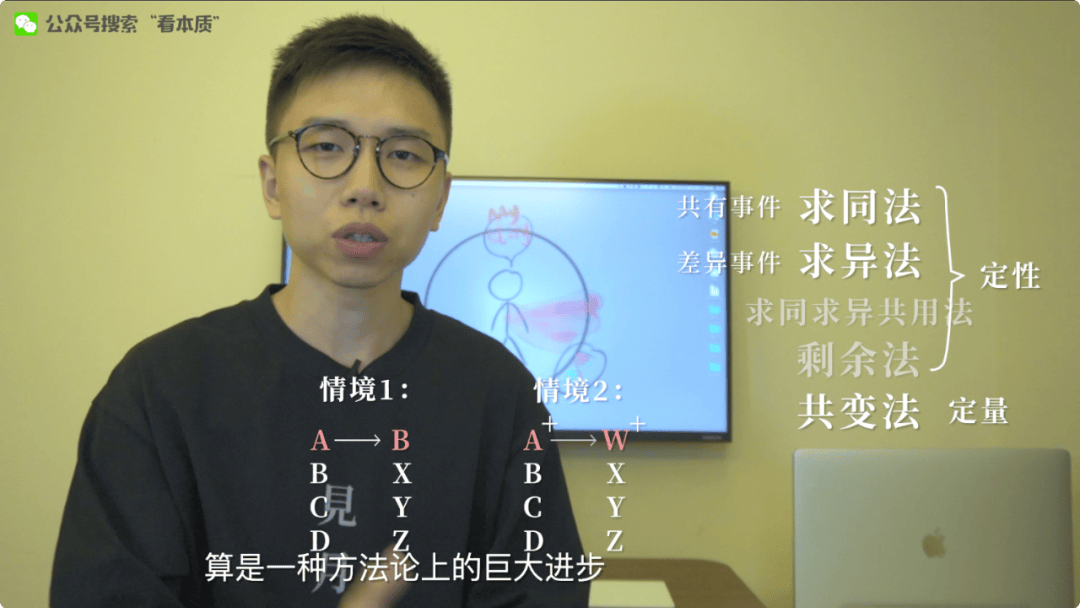
求同和求異是定性的推斷,它的結論要麼是有因果關係、要麼是沒因果關係,而共變法是定量的推斷,它追究得更具體,它問,A與w在多大程度上有關係。
從求同到求異,是研究思路上的轉變;從直觀到實證,則算得上是方法論上的進步;而從定性到定量,則是認知模式上的大轉型。這背後的深遠意義可能是連密爾自己都沒有意識到的。
從定性到定量
人類為萬物定量的歷史是從結繩記事開始的。我們創造數字,研究數學是為了創造一種語言和工具,用最精確的方式來描述萬事萬物之間的因果聯繫。一兩千年中,數學家們為此付出了卓絕的努力,誰曾想,到了20世紀,人類所有關於定量的智慧集結起來,反而直接消滅了因果聯繫。
今天的世界,一個被統計學籠罩的世界。
前面講到,任何一個對象都有無數細節,我們只能通過觀察有限的代表來認識它們,統計學說:我就是來幹這件事的!
在統計的世界裡,需要認識的對象是一個總體,我們無法直接研究總體,只能透過「樣本」間接地認識它。樣本的特徵就是可供統計的變量,這些變量的值(values)就是數據。當我們觀察的樣本足夠多時,我們就能找出變量變化的一般規律,獲得某個總體的參數,即關於某個對象知識。
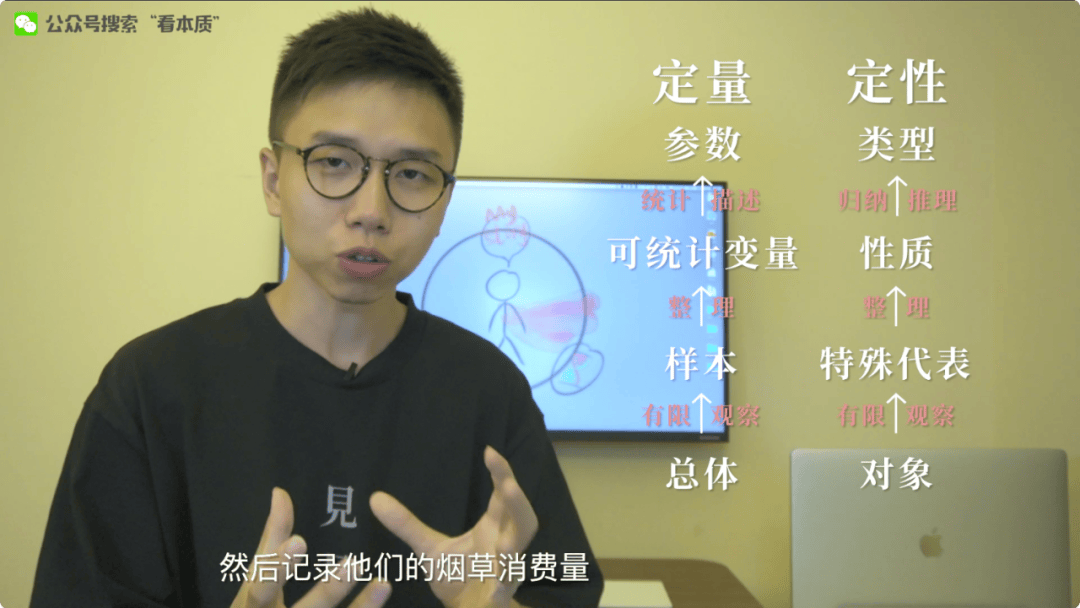
譬如,你想知道吸菸和肺癌之間是否存在因果關係,你可以找到1000個人(樣本),記錄他的菸草消費量和肺癌患病率這兩個變量的值,用一系列數學方法演繹出最終的結論。當然,這裡的結論並不是明確了它們的因果關係,而是得到它們之間的「相關係數」。
相關性是統計學先驅高爾頓在研究人體特徵時發明的概念,他發現身高高的人,臂長也相對更長,但這明顯不是因果關係,因為它們共同受到遺傳因子的影響,所以只能用相關性來描述。
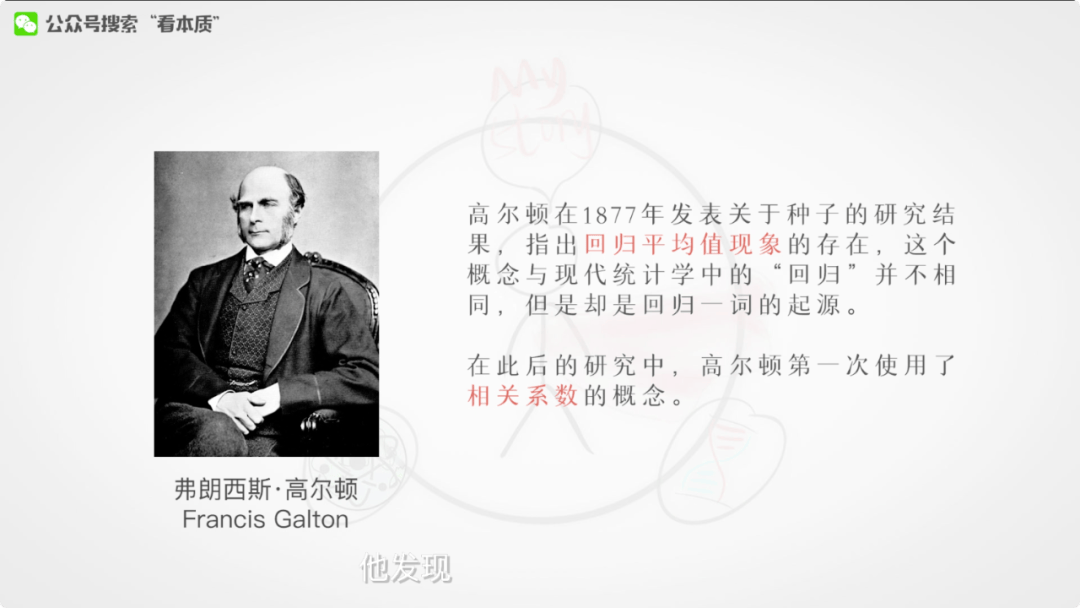
在高爾頓那裡,相關性還只是一個為因果關係辯護的證據。但在他的學生,也是另一位統計學先驅卡爾·皮爾遜看來。相關性是凌駕於因果之上的,他認為「存在一個比因果關係更廣泛的範疇,即相關性,而因果關係只是被囊括於其中的一個有限的範疇。」
因果關係被他降格成了相關關係中的一個特例,即在統計學上表現為相關係數為1或-1。假如吸菸量和肺癌患病率的相關係數為1,那麼意味著你多抽一個單位的煙,就多一個單位肺癌因子。
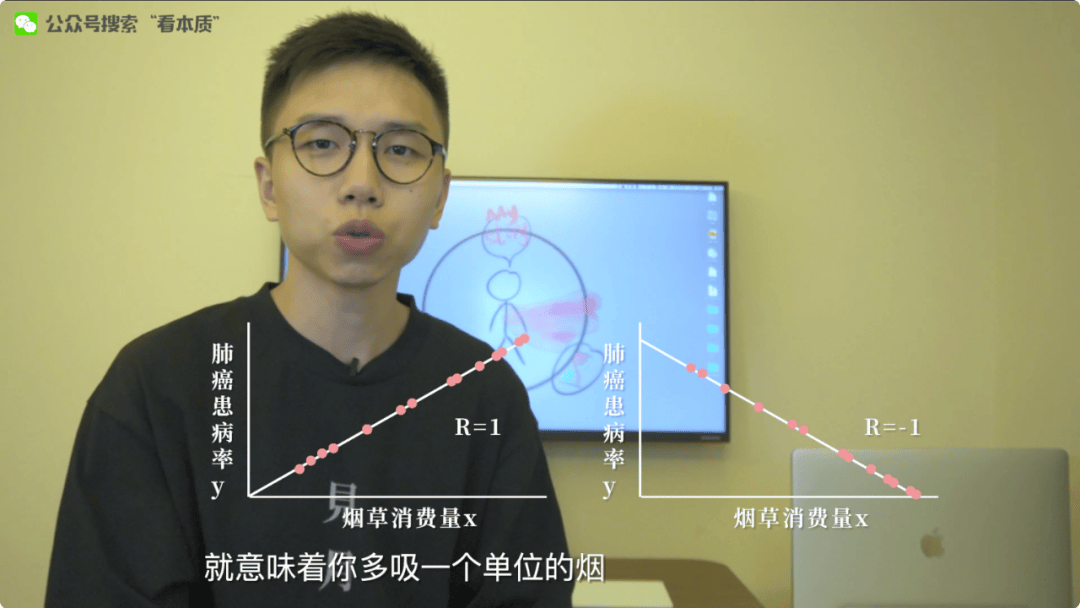
人們一般認為是相關性反映了因果關係,結果皮爾遜說,反了,是因果關係反映了相關性。因果只是人類的觀念,相關和概率才是自然的語言。
理論進步的同時,實證手段也得到了進一步的發展,統計學領域的集大成者費舍爾發明了隨機對照測試,堪稱人類有史以來最強實證手段。
數學家已經證明了隨機取樣的次數越多,樣本趨勢就越能代表總體的趨勢,更重要的是,隨機取樣能在最大程度上消除那些**「同時影響因果」的干擾因素對我們的影響,比如前面提到的天氣、睡眠和飲食等等,這類因素在統計學中被稱為混雜因子**(confounding factor),是妨礙人類發現因果聯繫的元兇。
假如我們在全世界範圍內隨機選取一萬人,他們雖然可能有類似的生活環境和飲食作息,但樣本選擇的隨機性分散了這些變量,稀釋了它們對樣本的影響,使得我們只需要關注跑步習慣和某項智力測試成績之間有沒有線性關係就夠了。
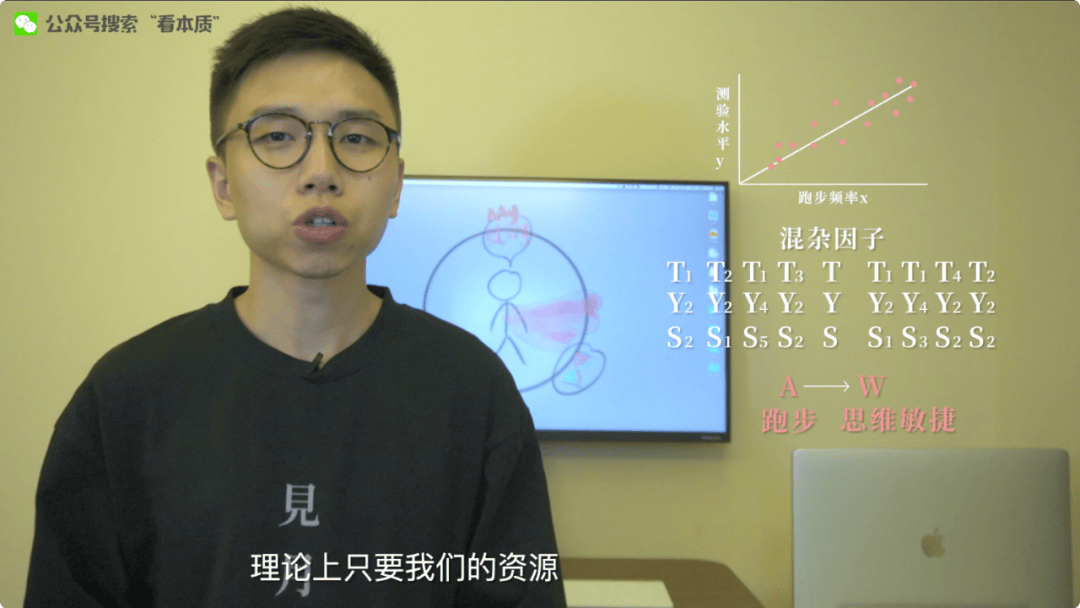
理論上,只要我們資源無限多,我們就能得到一張表達了人類所有可能的行為對應身心狀態變化關係的表格。這就是統計學給出的,關於人類這個總體的參數,也是我們得到的關於人類這個對象的知識。
皮爾遜曾說:「描寫兩個事物之間關係的終極科學表述,總可被概括為……一個列聯表」
今天,幾乎所有學科都在用統計學的語言描述著自己的研究成果,人們也多多少少地接受了皮爾遜所倡導的世界觀。
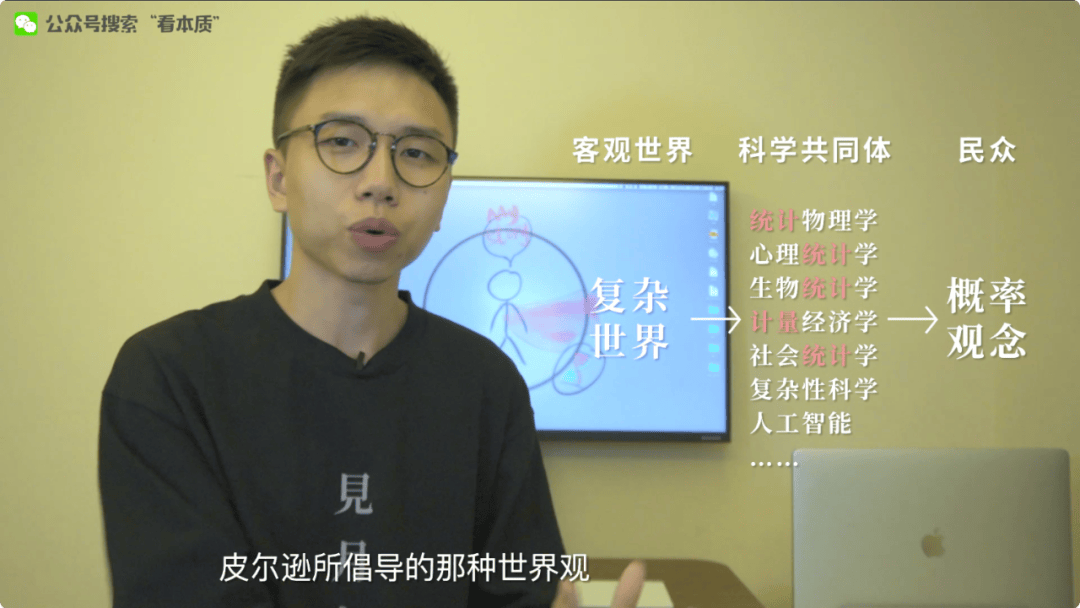
從二元到多元,從直觀到實證,從定性到定量,從因果推斷到概率分配,是人們對歸納價值和侷限性的認識逐步加深,應對手段逐漸升級的結果。
概括來說,歸納負責在經驗材料中建立類型化的對象,識別因果關係。歸納強度的提升,讓對象更加具體,關係更加明確。藉助統計手段,讓人們得以處理無限大的對象——再大的總體,也可以通過有限的樣本來間接地認識,特徵成了變量。我們把這些「量」帶入到嚴謹的推理空間,演繹出了一系列可靠的相關關係,最終建立了我們需要的功能性聯繫。
那些放之四海而皆準的科學知識,是高強度的歸納加上的高精度的演繹的產物。
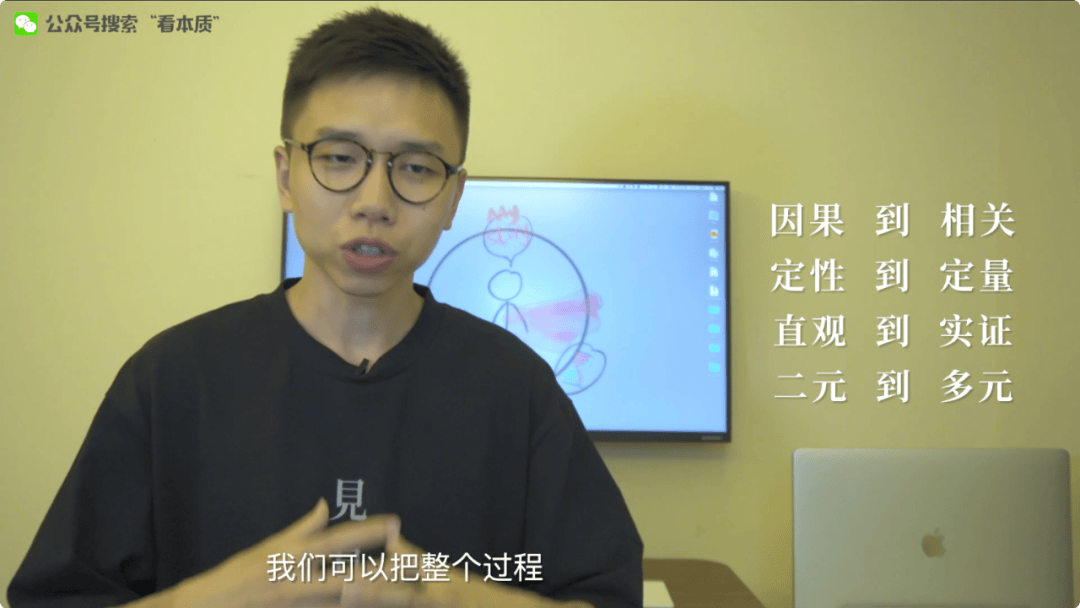
這麼看來,今天的知識似乎已經無限逼近它的最終目的了:確定過去和現在已知事實與將來的事實之間的關係,從而由當前狀況產生的唯一一種可能性。
注意,這句話的重點在「無限逼近」。
嚴肅的論文在報告它們的研究成果時都會說:準確率、成功率高達99.96%,你去做親子鑑定,醫生會告訴這個小朋友99.999%是你的孩子……。
這就是基於歸納的知識最尷尬的地方。
吸菸真的導致肺癌嗎?
大家看到的這張圖,顯示了1900年到1960年人均吸菸量和肺癌死亡率的增長趨勢。
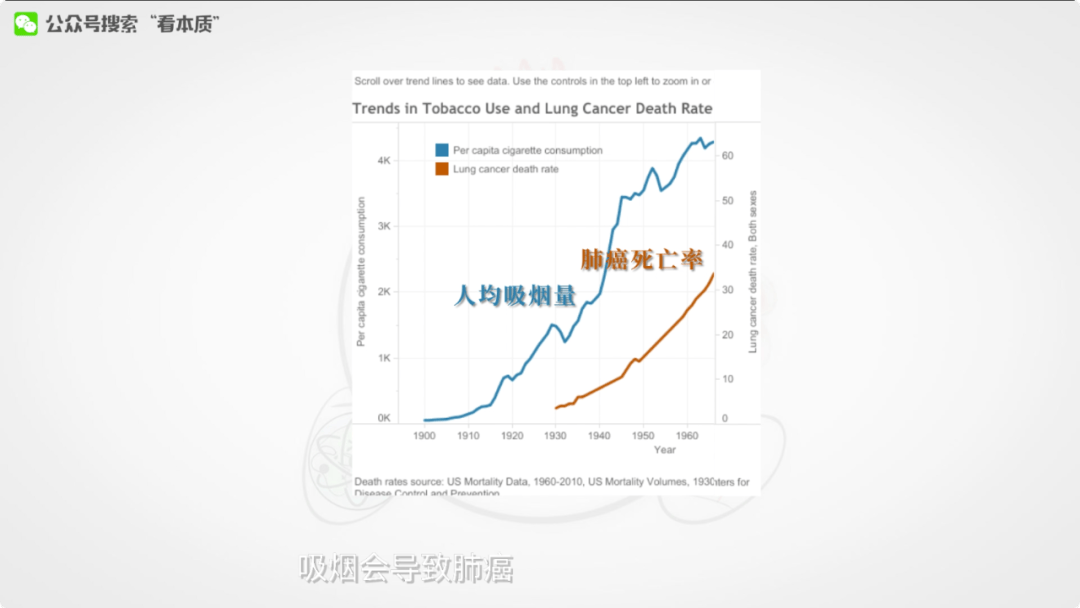
這60年間,美國菸草銷量猛增,肺癌也從一種罕見疾病變成了男性最常見癌症之一,大量證據指向吸菸會導致肺癌。但即便如此,人們也總能找到理由來否認這些證據,比如很多老煙槍都會說:「人家張學良老將軍天天抽菸喝酒燙頭,照樣活到103歲,怎麼解釋」。
孤例當然不需要討論,但比較有說服力的說法是,這60年,人類的生存環境發生了劇烈的變化,汽車尾氣的排放量在持續增加,工業發展導致空氣質量在持續惡化,這些都有可能導致肺癌患病率增加,你怎麼偏偏就和香菸過不去呢?
即便我們用隨機抽樣大法,捕捉到了抽菸頻率和病死率的相關性,高明的反對者依然可以說,可能是某種基因上差異導致了某些人就是容易對吸菸上癮。這些基因可能還會導致其他不健康的生活習慣,導致這些人得肺癌概率比普通人高,而吸菸只是誘發了這種基因的表達而已。沒有這種基因的人吸菸提神醒腦,有益無害。
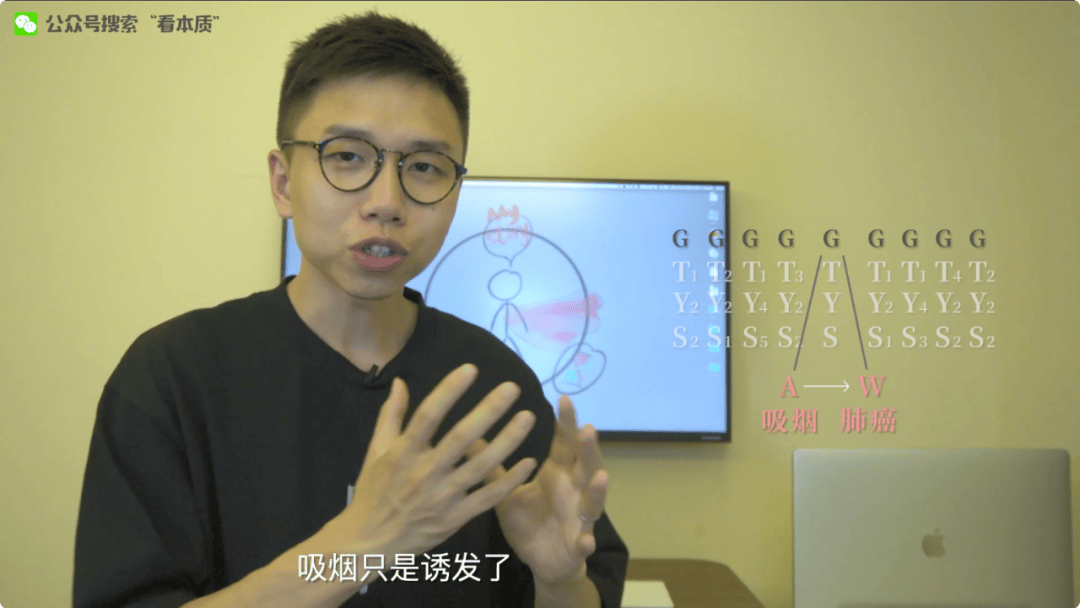
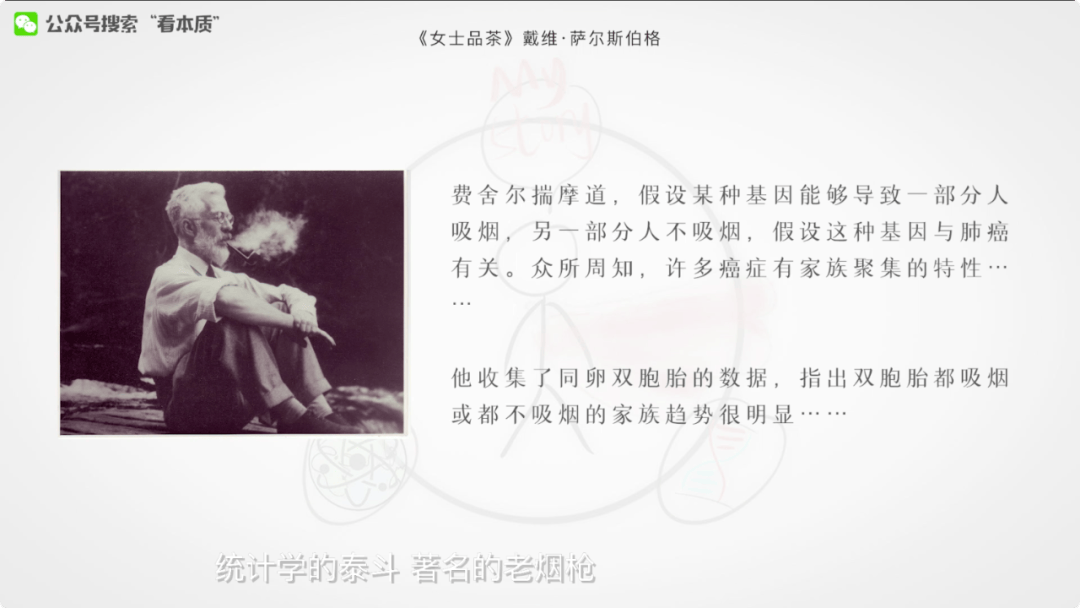
高明反對者中的代表人物,不是別人,正是統計學泰斗兼老菸民費舍爾同志。
在當時的技術條件下,人們是無法證偽這件事的。事實上,21世紀初人們真的發現了類似的基因,有些人抽菸就是容易上癮……
你會發現,有些反對意見看起來是非常犀利、合理、甚至還有些“先見之明”。且不論真正的因果為何,它們至少表明了,僅憑統計學的結論,我們得到的“事實”是非常脆弱的。
壓倒性的證據依然出現在實驗室裡。
20世紀50年,醫學期刊上已經出現了關於吸菸有害的實驗證據,比如研究者在老鼠的身上塗抹煙焦油,結果倒霉的小老鼠患上了癌症,人們還在煙霧中發現此前已知的致癌物,雖然在邏輯上老鼠患癌不等於人患癌,致癌物能致癌可能是另一個統計的結果,但這個時候再耍流氓就不合適了,實驗證據結合之前的統計數據,已經形成了一個了強有力的證據鏈。
這才有了這張圖的後半段,人均菸草消費量的峰值出現在1964年。當年美國衛生局長在一份報告中聲明:「在男性中,吸菸與肺癌有因果關係」。隨後菸草銷量驟降,肺癌死亡率也隨之下降。
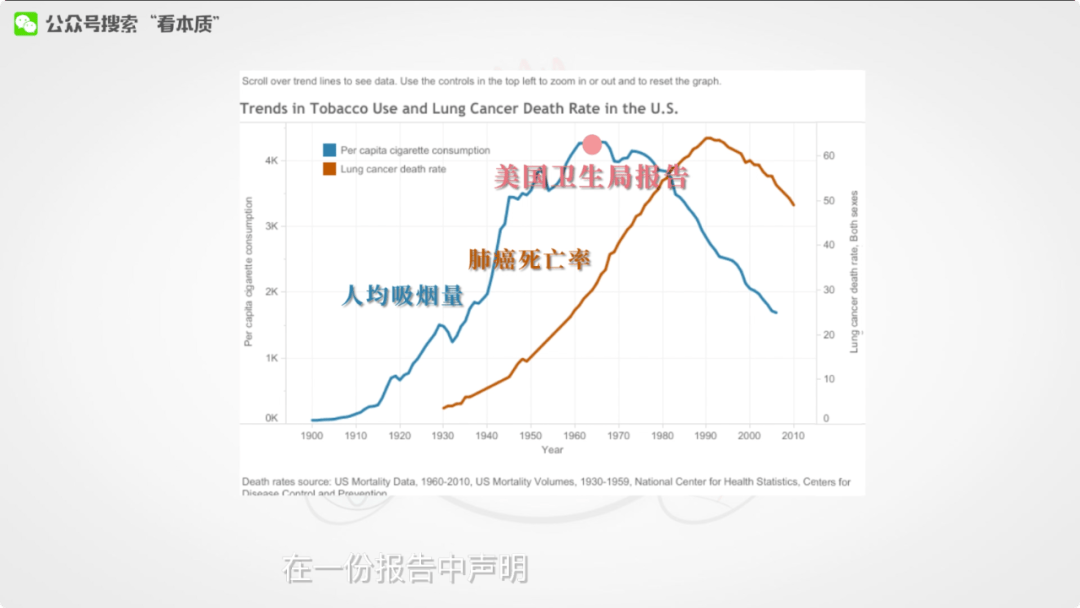
回看這100年的數據,你會發現人類完成了一次極其成功的公共衛生干預事件,可當你深入瞭解60年代之前的那段歷史,又能體會到人類用統計來捕獲因果時的尷尬。
現象暗海上的浮木
花篇幅講這個例子,是為了引出了一個思考:在我們對世界認知存在盲維,且實證手段存在侷限的前提下,那些統計意義上的可靠知識究竟有多可靠?
基因曾是我們的盲維,高精度的化學提純也是科學革命之後的才能做到事,我們有幸跨過去了,如今我們的前沿科學面對的是一個亂丟骰子的上帝,和一個在理論上存在卻怎麼也探測不到的暗世界。
盲維總是存在,觀測手段總有侷限,這個前提似乎是無法擺脫的,我們在很長時間裡都離不開統計意義上可靠知識。
意識到這點,你就能理解能皮爾遜那些離經叛道的觀點了——對於人類來說,概率似乎比因果更真實。我們漂浮在暗海之上,海里充滿了各種混雜因子,影響著潮水的方向,那些知識,是我們能抓住的最粗壯的浮木。
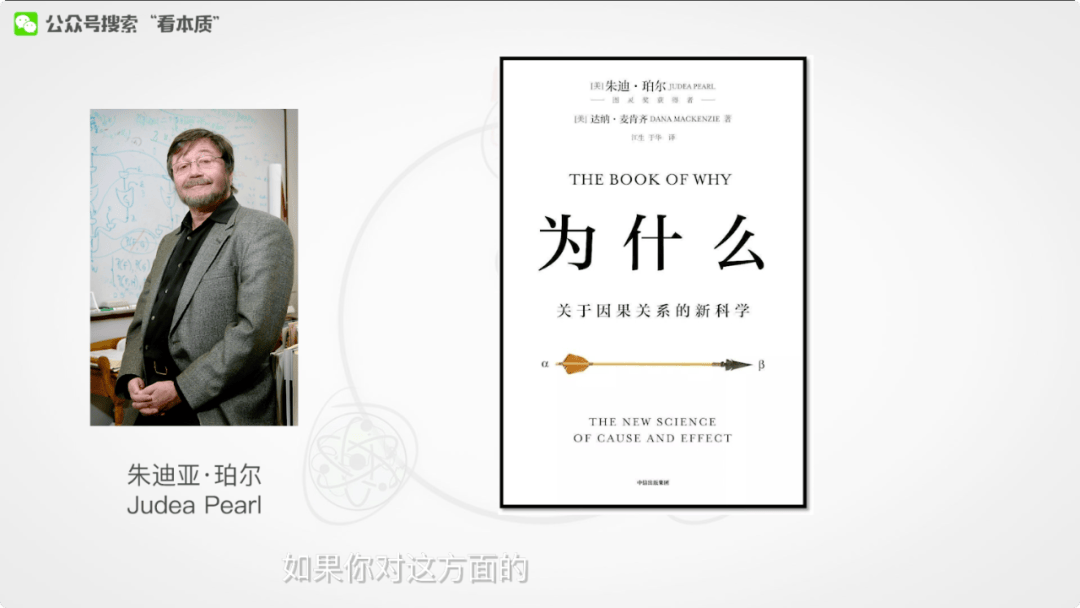
因果推斷問題至今仍然是一個很熱門的學術問題,學者提出了很多新的理論來克服統計研究方法帶來的因果推斷困難問題,如果你對這方面的前沿理論感興趣,可以看看這本書,寫得極其精彩。
因果推斷問題之所以把科學家們搞的焦頭爛額,問到根上,還是因為歸納和因果的問題是一個典型的哲學認識論問題。
早於密爾100年、皮爾遜300年,休謨挖的那個坑,到今天都沒有被填上。
休謨之叉
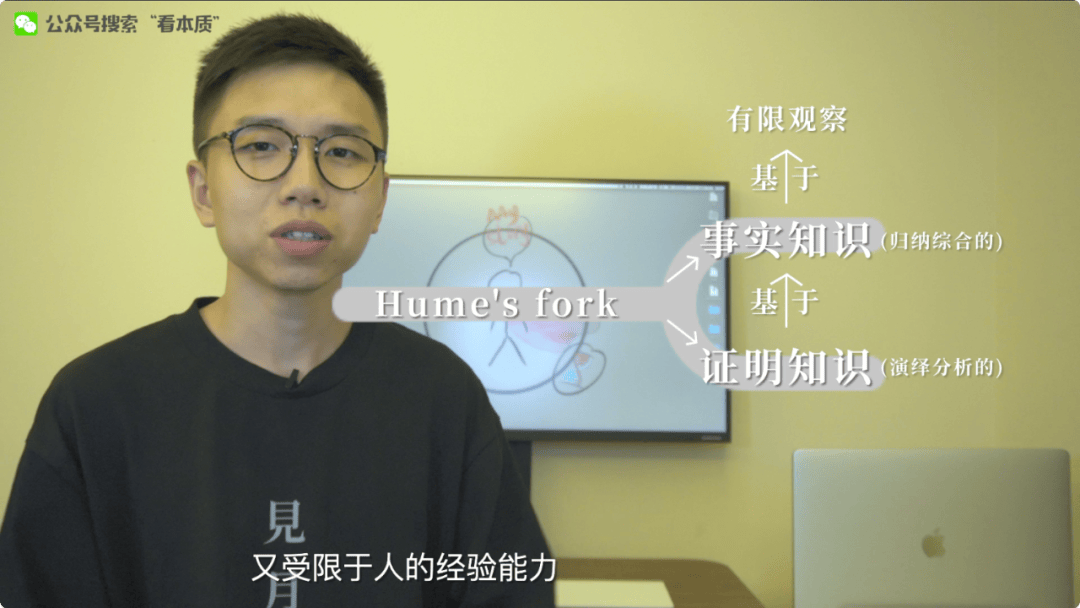
休謨曾把人類的知識分成兩種:一種是關於事實的知識,比如所有天鵝都是黑色的,來自於我們的經驗,相當於歸納的、綜合的知識。
另一種是與現實無關,是純粹的理念性的知識,他叫做「證明的知識」,相當上期我們講到的於演繹的、分析的知識,比如形式邏輯、數學推導就是證明的知識。
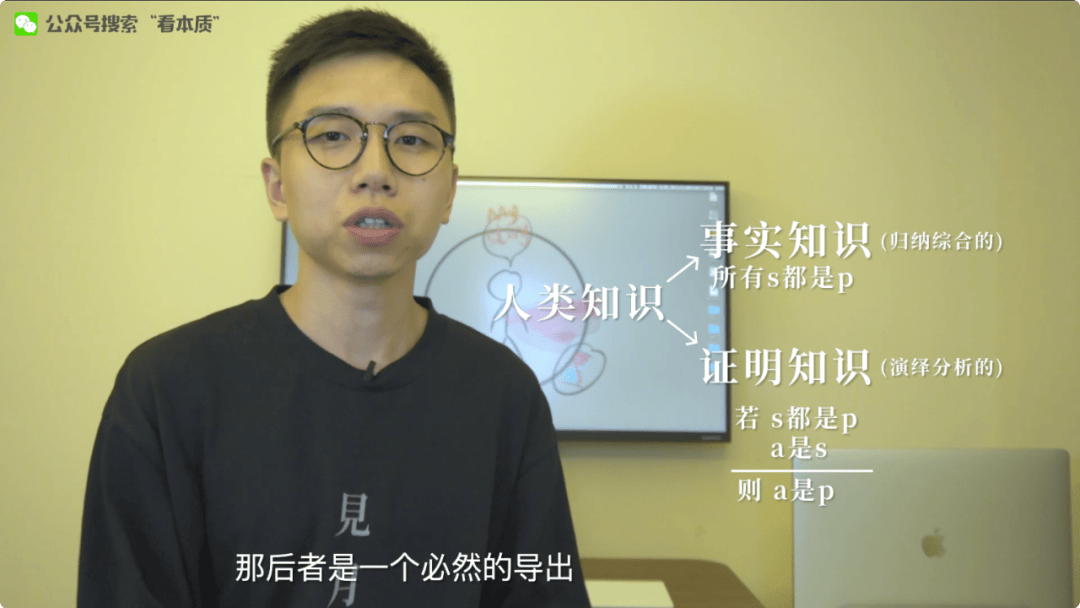
這種二分法就是傳說中的哲學神器之一——休謨之叉,一把插入知識的深處,摧毀了知識的根基。所有演繹的都必須基於歸納的知識之上展開,歸納又永遠受限於人類有限的經驗能力。
密爾、費舍爾的工作不過是把這個叉子捏得更緊一點而已,但間隙總是存在的,那0.0001%就是證明。
回顧上文的一個觀點:
有些嚴肅的科學知識看起來格外牛逼,有數學化的表達形式,有精確的預測能力,看起來和前面這些簡單歸納出來的傢伙完全不是一路貨色,本質上它們都是經驗模型,同樣是歸納。
從原始的二分法到定量統計,技術上不斷升級,但知識的內核沒有變過。
物理與諸神
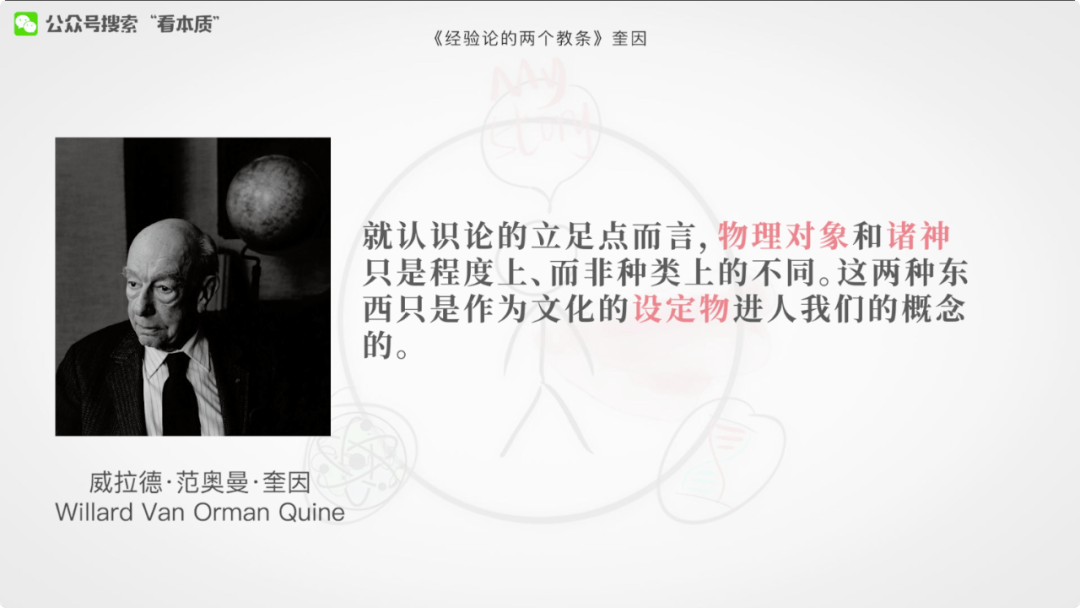
哲學家奎因說:「就認識論的立足點而言,物理對象和諸神只是程度上、而非種類上的不同。這兩種東西只是作為文化的設定物進入我們的概念的」
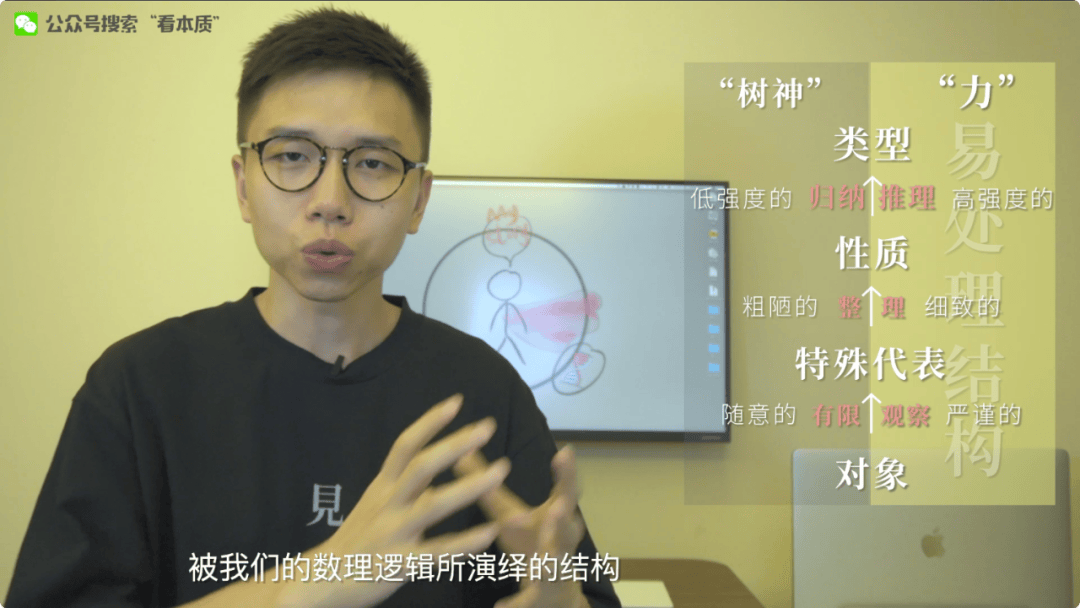
類似的話皮爾遜也說過:「力作為運動的因,與樹神作為生長的因可以等同視之」
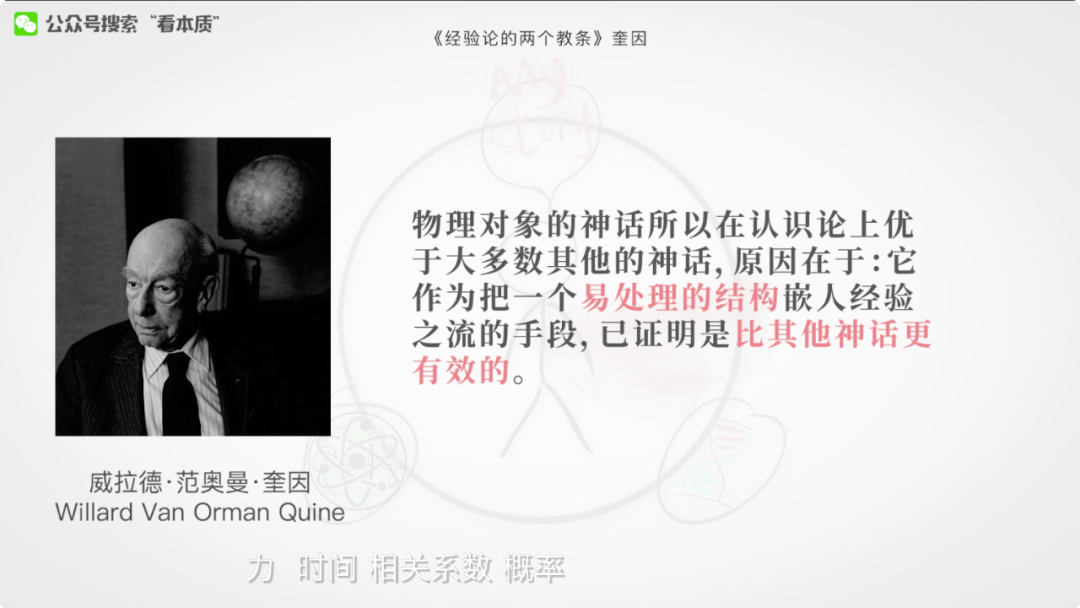
而奎因在下一句裡道出了重點:「物理對象的神話之所以在認識論上優於大多數其他的神話,原因在於:它作為把一個易處理的結構嵌人經驗之流的手段,已證明是比其他神話更有效的。」
力、時間、參數、概率,它們是更容易被處理的結構,準確地說,是更容易被實驗手段測定、被數理邏輯演繹的結構。通過這些“處理”,我們在混雜無序、相互勾連的經驗場域中搭建出一個變量有限的空間,在其中學習前人總結出的變量間的功能性聯繫,來應對世界的不確定。
事實已證明,人類從這個空間裡獲得的指導,比從神話寓言、宗教訓誡裡獲得的更有效。
但你不要把科學當成新的神話和宗教,這是原始人的歸納法。
思維之火
講完歸納推理,會給大家造成一種錯覺,好像把歸納和演繹的來龍去脈說清楚,就足夠解釋我們知識和構成和認知的規律了。
但這真的是一個錯覺,我們至多能說,對歸納和演繹規範化應用讓我們獲得了結構清晰的知識,但人類的認知過程是非常複雜的,我能說出這些知識,你能理解這些知識的意義、內涵與話外之音,中間有一系列奇妙的事情發生。
在歸納和演繹之前,在結構化知識之下,還有一片未知地帶,那裡藏著人類思維之所以如此神奇的秘密。
下一期我們要追本溯源,進入認知語言學的世界,見識一下思維之火,類比。
類比推理在傳統邏輯學中是跑龍套的角色,經常淪為歸納推理下的一個子類,但在認知語言學中,它卻成了扛大旗的主角,大量的認知語言學研究是圍繞著「類比」展開的。
比如我手上這本《表象與本質:類比,思考之源與思維之火》,作者是認知科學界的大神「候世達」,厚厚的一本書,只論證了一個觀點:類比是人類認知的核心。
何以如此?我們下期再談。